

HashMap的工作原理
面试常从“你用过 HashMap 吗?什么是 HashMap?为什么用它?”问起。多数人会答:是的,然后列出特性——HashMap 可以接受 null 键和值,Hashtable 不行;HashMap 非 synchronized;HashMap 很快;存的是键值对。这只能说明你用过它。接下来面试官会往原理上追。
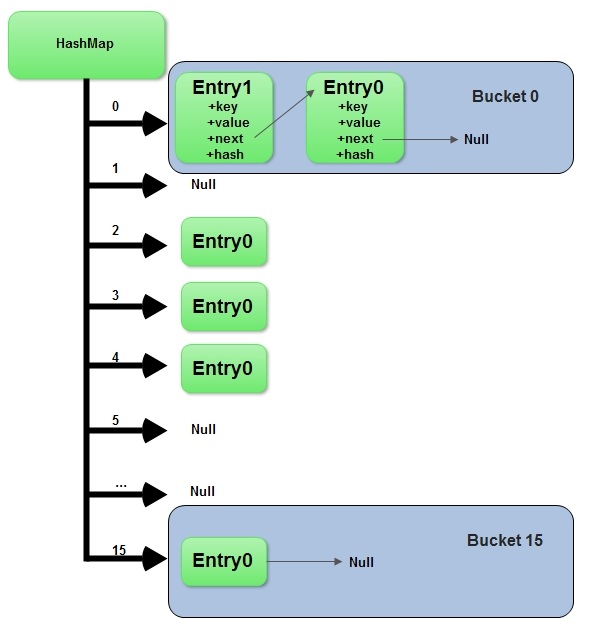
“你知道 HashMap 的工作原理吗?get() 怎么工作?”有人会说去看源码或 Google。能答到点子上的人会说:HashMap 基于 hashing,用 put(key, value) 存、get(key) 取。调用 put 时先对键做 hashCode(),用返回值定位 bucket,再把 Entry(键对象+值对象) 放进去。关键点是 bucket 里存的是 Map.Entry,不是只存 value——否则后面“怎么取出对象”根本讲不清。
一、hashCode 相同:碰撞
“两个对象 hashcode 相同会发生什么?”有人会误以为对象相等、HashMap 抛异常或不存。面试官会提醒:equals() 和 hashCode() 是两回事,hashcode 相同也可以不相等。继续答:bucket 位置相同,发生碰撞。HashMap 用链表存对象,这个 Entry 会挂到链表上。处理碰撞的方法很多,链表是最简单的一种,也正是(Java 7 及更早)HashMap 的做法。
“两个键 hashcode 相同,如何获取值对象?”先用键的 hashcode 找到 bucket,再遍历链表。面试官会追问:你没有值对象可比较,怎么确定找到了?除非你知道链表节点里是键值对,否则答不上。记住这一点的人会说:找到 bucket 后调用 keys.equals() 找到正确节点,再取 value。完美答案。
很多人在这一环把 hashCode() 和 equals() 搞混:hashCode 一路出场,equals 只在取 value 时出现。优秀开发者还会补充:键用不可变、final 对象,并正确实现 equals/hashCode,能减少碰撞、提高效率。不可变性让 hashcode 可缓存,String、Integer 这类包装类当键很合适。
二、负载因子与扩容
“HashMap 大小超过负载因子(load factor)定义的容量怎么办?”默认负载因子是 0.75:bucket 填到 75% 时,会创建原来两倍大小的 bucket 数组,把旧对象放进去。这个过程叫 rehashing,因为要再调 hash 找新位置。
“重新调整大小有什么问题?”多线程下可能产生条件竞争(race condition)。两个线程同时发现需要扩容,会一起调整。移动到新 bucket 时,HashMap 把元素放在链表头部而不是尾部(避免尾部遍历),链表次序会反过来。条件竞争一旦发生,可能死循环。这时可以反问:为什么要在多线程里用 HashMap?
| 问题 | 要点 |
|---|---|
| put / get | hashCode 定位 bucket,Entry 存键值对 |
| 碰撞 | 同一 bucket 用链表(Java 8 起长链会转红黑树) |
| 取 value | bucket 内用 key.equals() 找到节点 |
| 负载因子 | 默认 0.75,超了扩容为约 2 倍并 rehash |
| 多线程扩容 | 链表头插可能导致死循环,改用 ConcurrentHashMap |
三、键的选择与 ConcurrentHashMap
为什么 String、Integer 适合当键? 它们不可变、final,已重写 equals 和 hashCode。不可变性必要:计算 hashCode 时键不能变,否则放入和取出时 hash 不同,就找不到对象。不可变还有线程安全等好处。两个不相等的对象若返回不同 hashcode,碰撞更少,性能更好。
可以用自定义对象当键吗? 可以,只要遵守 equals/hashCode 约定,并且插入 Map 后不再改变。自定义对象若不可变,创建后就不能改,已经满足当键的条件。
能用 ConcurrentHashMap 代替 Hashtable 吗? Hashtable 整表 synchronized;ConcurrentHashMap 只锁一部分(分段或桶),同步性能更好。可以代替 Hashtable,但 Hashtable 提供更强的整表互斥。详见 这篇博客。
四、这些问题覆盖哪些知识点
-
hashing 的概念 -
HashMap 中解决碰撞的方法 -
equals() 和 hashCode() 的应用,以及它们在 HashMap 中的重要性 -
不可变对象的好处 -
HashMap 多线程的条件竞争 -
重新调整 HashMap 的大小
注:哈希表——在对象存储位置和关键属性 k 之间建立对应关系 f,使每个对象对应唯一位置。查找时计算 f(k);若对象在集合中,必在 f(k) 上。称 f 为哈希方法,按此建立的表为哈希表。
五、工作原理小结
HashMap 及其子类用 Hash 算法决定元素位置。初始化时创建长度为 capacity 的 Entry 数组,可存元素的位置叫“桶(bucket)”,按索引可快速访问。每个桶通常先存一个 Entry;Entry 可指向下一个 Entry,于是形成 Entry 链:桶里只有一个头结点,但它串着一条链。
put 时对键算 hashcode 找 bucket;get 时先找 bucket,再用 equals 找正确键值对。碰撞时对象放在链表下一节点。每个链表节点存的是键值对对象。两个不同键 hashcode 相同时,它们在同一 bucket 的链表里,靠 equals 区分。
因为 HashMap 好处很多,曾在电商应用里拿它当缓存。金融领域也很常用 HashMap 和 ConcurrentHashMap。
原文:Javarevisited 翻译:ImportNew.com – 唐小娟 译文:http://www.importnew.com/7099.html
一句话总结:HashMap 用 hashCode 定位桶、用 equals 在链上找键;碰撞用链表,装满约 75% 就扩容 rehash——单线程很快,多线程扩容可能死循环。
转载请注明来源:HashMap的工作原理
周sir
我是周sir,这是我的博客。致力于分享我学会的技术和优秀的文章。微信公众号 “周sir专栏” 欢迎大家关注。
你可能也喜欢
你必须要知道的JavaScript数据结构与面试题解答
ConcurrentHashMap与CAS
迭代器(Iterator)

JAVA排序汇总