十大经典排序是前端面试高频题:冒泡、选择、插入、希尔、归并、快速、堆、计数、桶、基数。来源:https://segmentfault.com/a/1190000010413296。下面按原文保留算法步骤、动图和 JavaScript 实现;顺手修正 functiion paritition2 的拼写。
比较类排序平均多在 O(n log n) 到 O(n²);计数、桶、基数属于非比较排序,在整数、范围可控时可以接近线性,但要额外空间和约束条件。
一、冒泡排序
冒泡排序重复走访数列,两两比较,顺序错了就交换,直到没有需要交换的元素。名字来自越小的元素经交换慢慢“浮”到顶端。作为最简单的排序之一,它像单词书里的 Abandon,总在第一页。优化是立一个 flag,一趟没有交换就说明有序,但对性能帮助有限。
算法步骤
-
-
对每一对相邻元素做同样工作,结束后最后的元素是最大的数
-
-
动图演示:
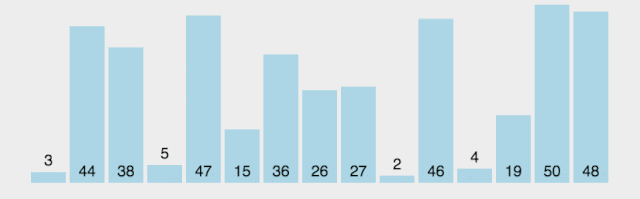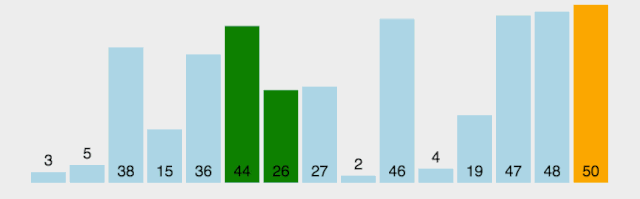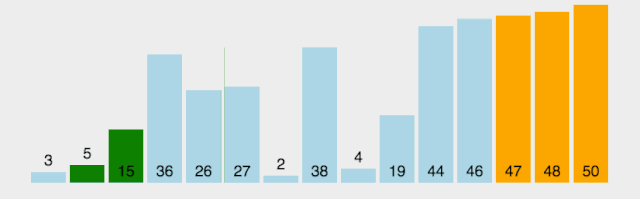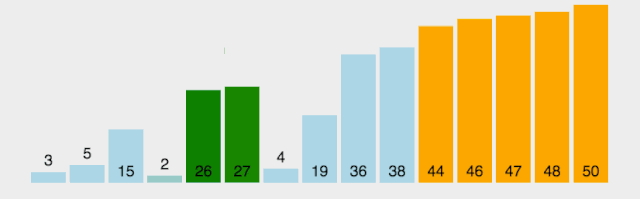
最快:输入已是正序。最慢:输入反序。
function bubbleSort(arr) {
    var len = arr.length;
    for (var i = 0; i < len - 1; i++) {
        for (var j = 0; j < len - 1 - i; j++) {
            if (arr[j] > arr[j+1]) {        // 相邻元素两两对比
                var temp = arr[j+1];        // 元素交换
                arr[j+1] = arr[j];
                arr[j] = temp;
            }
        }
    }
    return arr;
}
二、选择排序
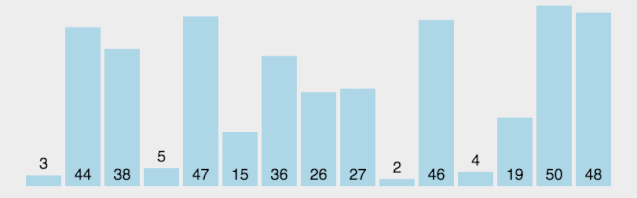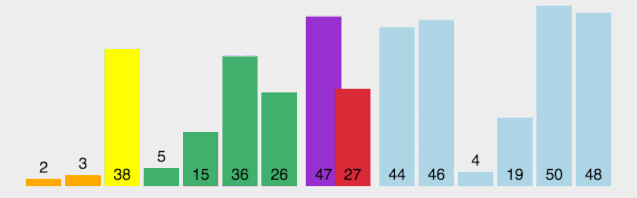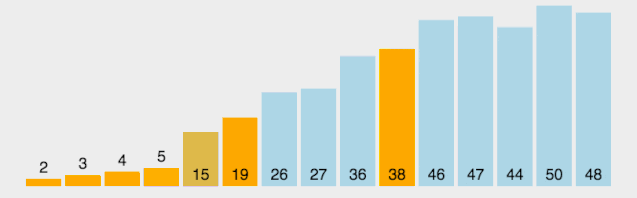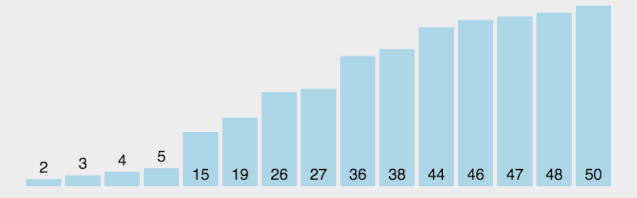
无论什么数据进去都是 O(n²),数据规模越小越好。好处是不占额外内存。
-
在未排序序列中找最小(大)元素,放到排序序列起始位置
-
再从剩余未排序元素中继续找最小(大),放到已排序末尾
-
动画演示:
function selectionSort(arr) {
    var len = arr.length;
    var minIndex, temp;
    for (var i = 0; i < len - 1; i++) {
        minIndex = i;
        for (var j = i + 1; j < len; j++) {
            if (arr[j] < arr[minIndex]) {     // 寻找最小的数
                minIndex = j;                 // 将最小数的索引保存
            }
        }
        temp = arr[i];
        arr[i] = arr[minIndex];
        arr[minIndex] = temp;
    }
    return arr;
}
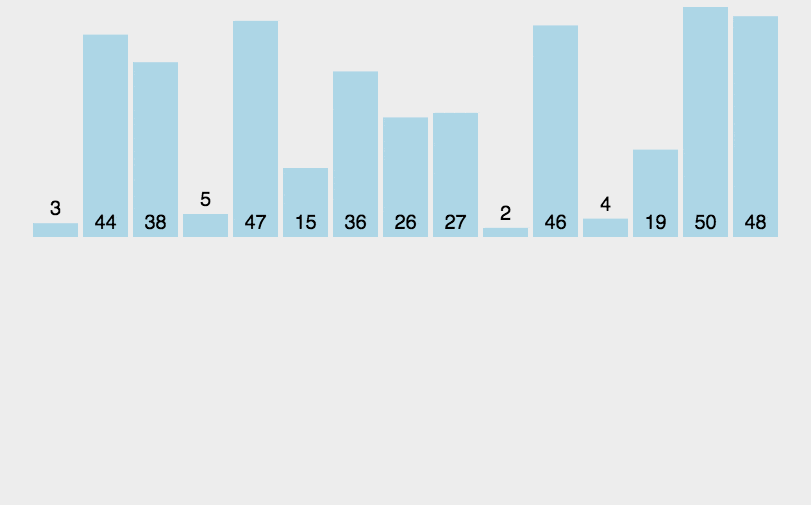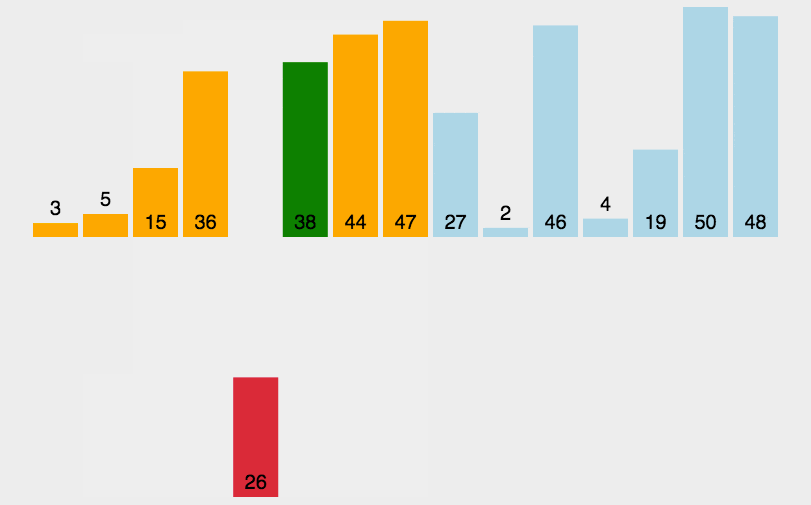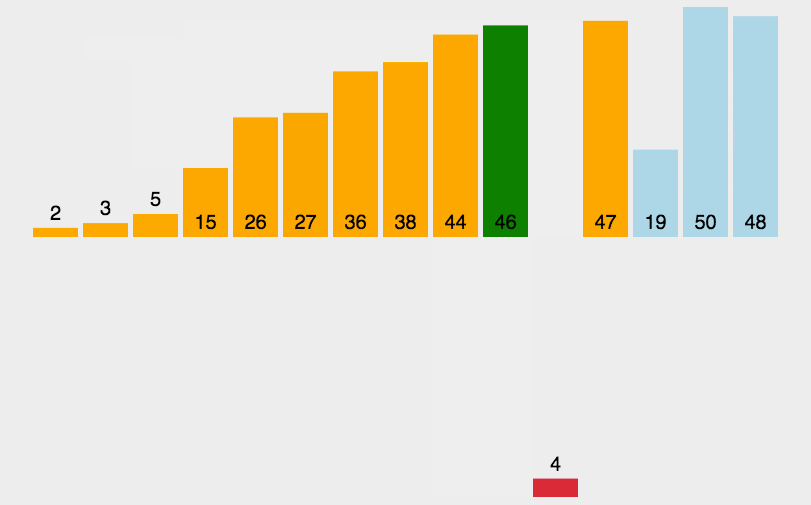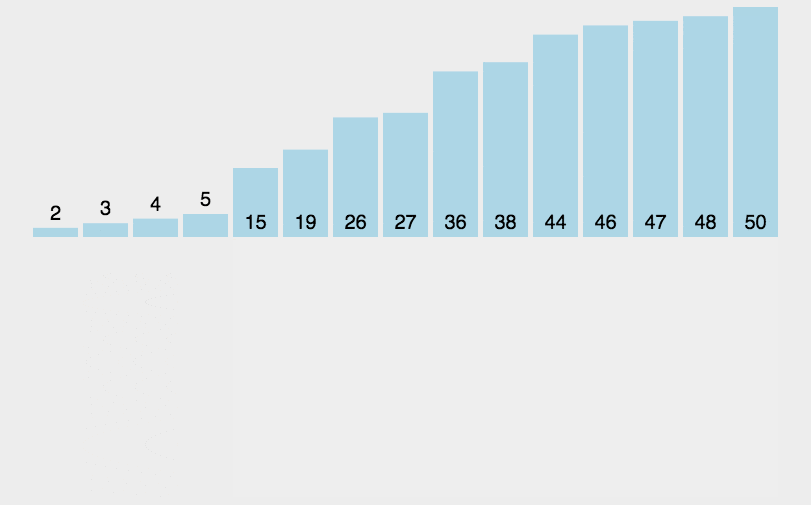
三、插入排序
原理最好懂:打过扑克就会。通过构建有序序列,对待排序数据从后向前扫描,找到位置插入。和冒泡一样也有优化叫折半插入。
-
-
依次把未排序元素插入有序序列的适当位置(相等则插到后面,保证稳定)
动图演示:
function insertionSort(arr) {
    var len = arr.length;
    var preIndex, current;
    for (var i = 1; i < len; i++) {
        preIndex = i - 1;
        current = arr[i];
        while(preIndex >= 0 && arr[preIndex] > current) {
            arr[preIndex+1] = arr[preIndex];
            preIndex--;
        }
        arr[preIndex+1] = current;
    }
    return arr;
}
四、希尔排序
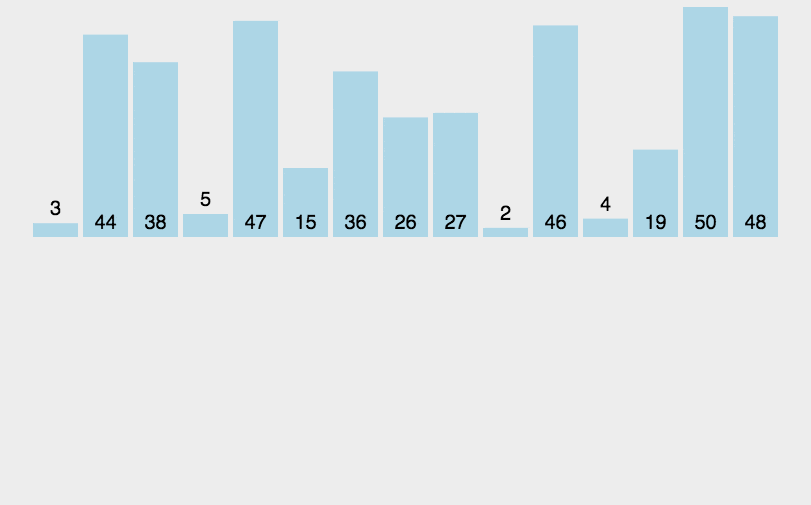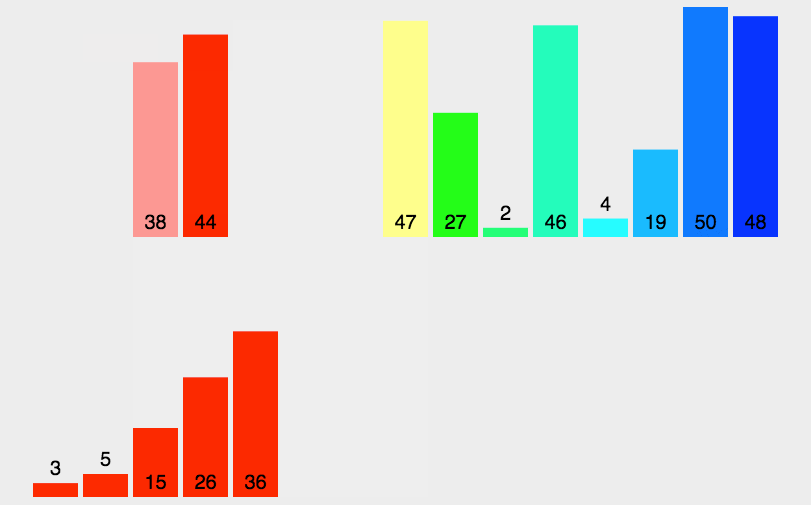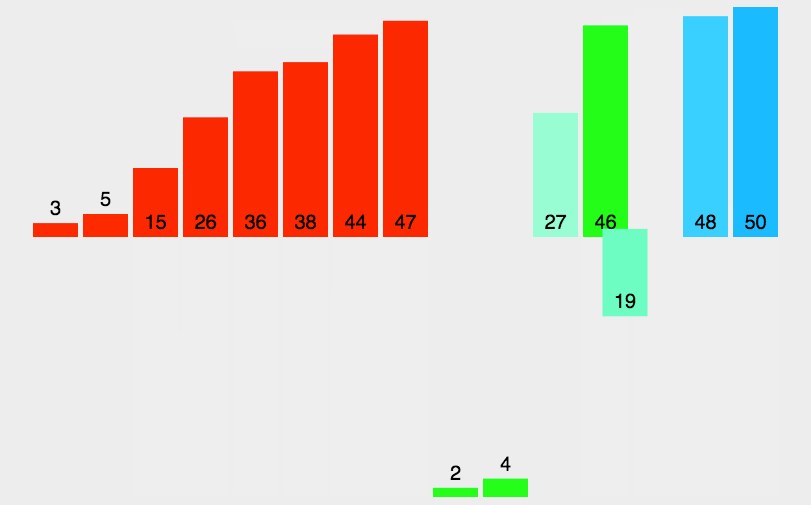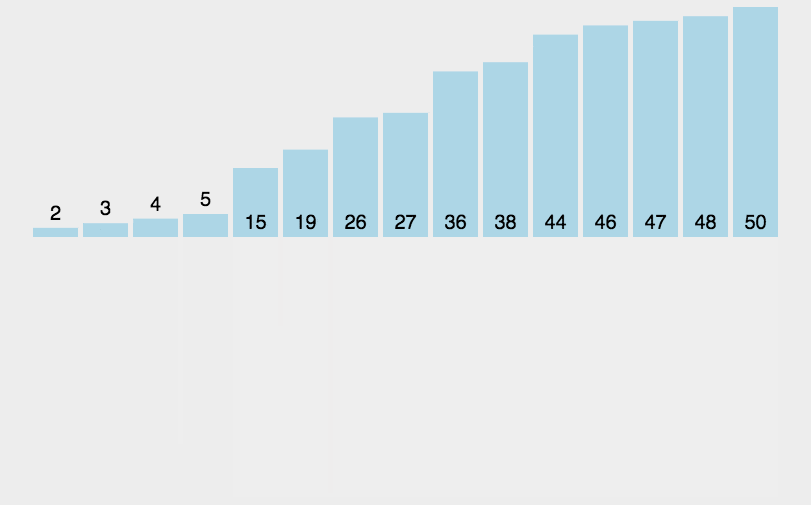
希尔排序也称递减增量排序,是插入排序更高效的改进版,但是不稳定。它利用两点:插入排序对接近有序的数据可以接近线性;普通插入每次只能移一位所以慢。做法是先按增量把序列分成若干子序列做直接插入,基本有序后再做一次增量为 1 的插入。
-
选择增量序列 t1, t2, …, tk,其中 ti > tj,tk = 1
-
-
每趟按 ti 分割成若干子表做直接插入;ti = 1 时就是对整个表插入
动画演示:
function shellSort(arr) {
    var len = arr.length,
        temp,
        gap = 1;
    while(gap < len/3) {          //动态定义间隔序列
        gap =gap*3+1;
    }
    for (gap; gap > 0; gap = Math.floor(gap/3)) {
        for (var i = gap; i < len; i++) {
            temp = arr[i];
            for (var j = i-gap; j >= 0 && arr[j] > temp; j-=gap) {
                arr[j+gap] = arr[j];
            }
            arr[j+gap] = temp;
        }
    }
    return arr;
}
五、归并排序
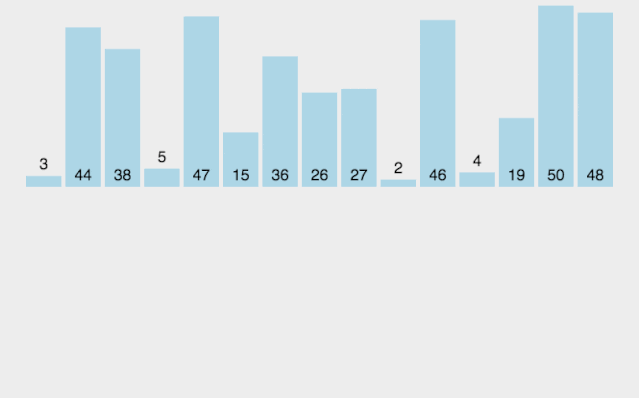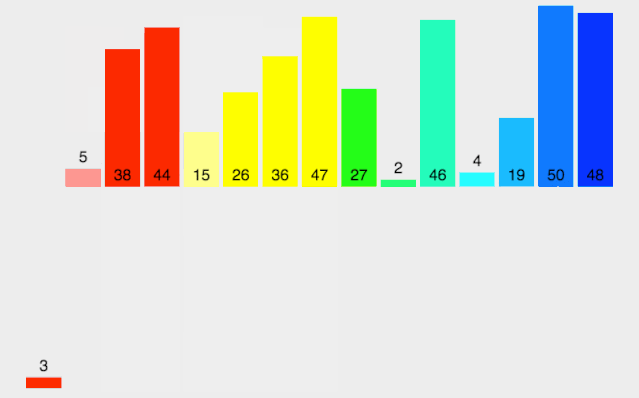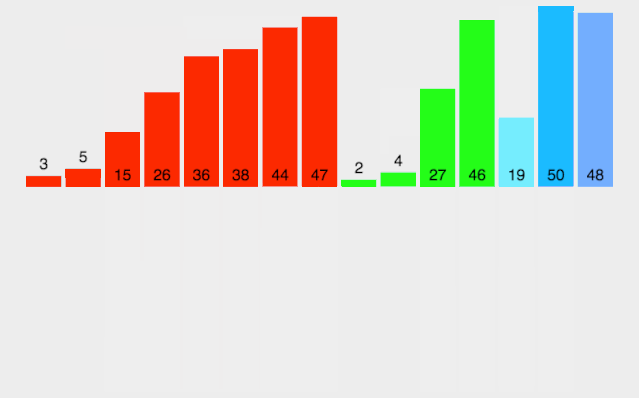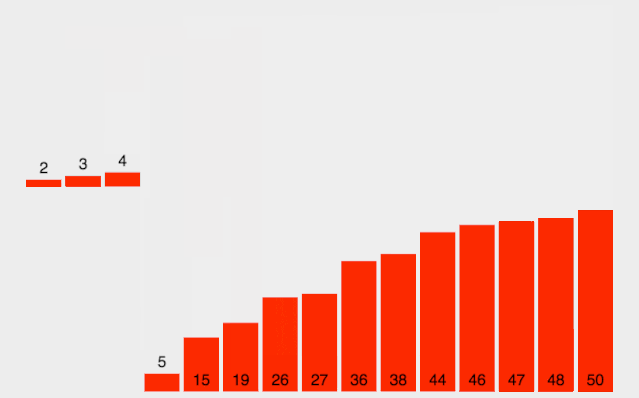
归并是分治法的典型应用,可以自上而下递归,也可以自下而上迭代。性能不受输入数据影响,始终 O(n log n),比选择排序好得多,代价是额外内存。
-
申请一块等于两段有序序列之和的空间,用来放合并结果
-
-
-
动图演示:
function mergeSort(arr) {  // 采用自上而下的递归方法
    var len = arr.length;
    if(len < 2) {
        return arr;
    }
    var middle = Math.floor(len / 2),
        left = arr.slice(0, middle),
        right = arr.slice(middle);
    return merge(mergeSort(left), mergeSort(right));
}

function merge(left, right)
{
    var result = [];

    while (left.length && right.length) {
        if (left[0] <= right[0]) {
            result.push(left.shift());
        } else {
            result.push(right.shift());
        }
    }

    while (left.length)
        result.push(left.shift());

    while (right.length)
        result.push(right.shift());

    return result;
}
六、快速排序
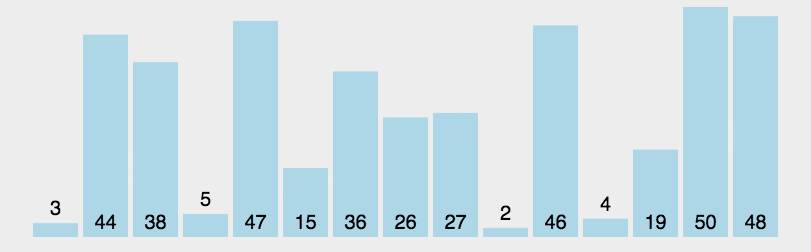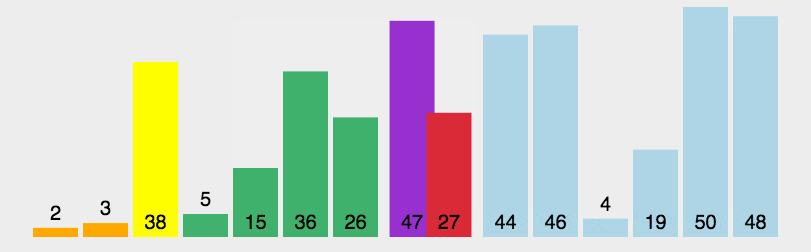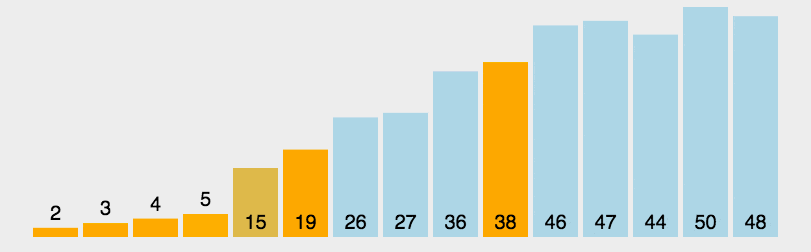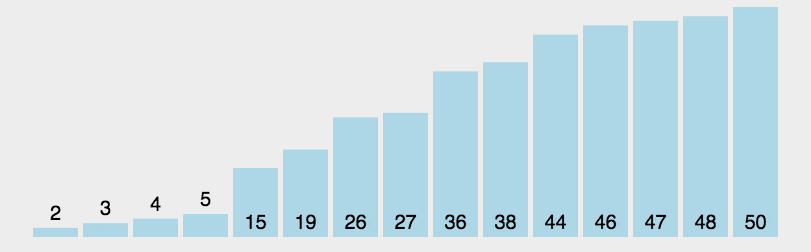
快速排序由东尼·霍尔提出,平均 O(n log n),最坏 O(n²) 但不常见。内部循环在多数架构上很好实现,处理大数据时常比其他 O(n log n) 算法更快。它用分治把序列分成两个子序列,本质上可看成冒泡基础上的递归分治。
-
-
比基准小的放左边,大的放右边(分区 partition)
-
-
长度为 0 或 1 时天然有序,算法总会结束,因为每轮至少放好一个元素
动图演示:
下面同时保留原文的 partition 与 partition2 两种写法。
function quickSort(arr, left, right) {
    var len = arr.length,
        partitionIndex,
        left = typeof left != 'number' ? 0 : left,
        right = typeof right != 'number' ? len - 1 : right;

    if (left < right) {
        partitionIndex = partition(arr, left, right);
        quickSort(arr, left, partitionIndex-1);
        quickSort(arr, partitionIndex+1, right);
    }
    return arr;
}

function partition(arr, left ,right) {     // 分区操作
    var pivot = left,                      // 设定基准值(pivot)
        index = pivot + 1;
    for (var i = index; i <= right; i++) {
        if (arr[i] < arr[pivot]) {
            swap(arr, i, index);
            index++;
        }
    }
    swap(arr, pivot, index - 1);
    return index-1;
}

function swap(arr, i, j) {
    var temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}
function partition2(arr, low, high) {
  let pivot = arr[low];
  while (low < high) {
    while (low < high && arr[high] > pivot) {
      --high;
    }
    arr[low] = arr[high];
    while (low < high && arr[low] <= pivot) {
      ++low;
    }
    arr[high] = arr[low];
  }
  arr[low] = pivot;
  return low;
}

function quickSort2(arr, low, high) {
  if (low < high) {
    let pivot = paritition2(arr, low, high);
    quickSort2(arr, low, pivot - 1);
    quickSort2(arr, pivot + 1, high);
  }
  return arr;
}
七、堆排序
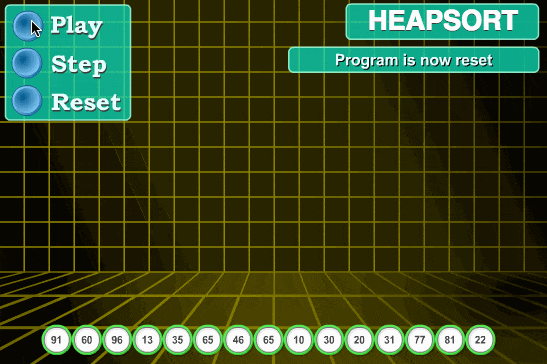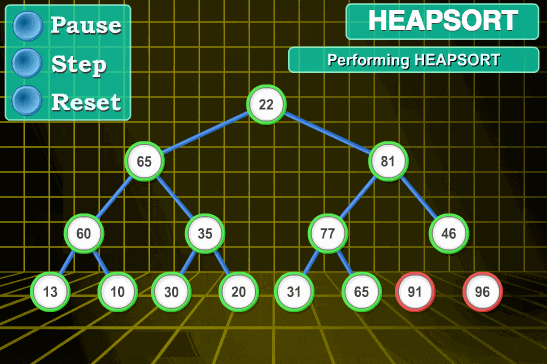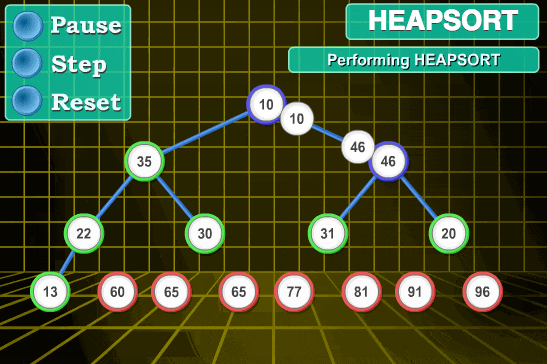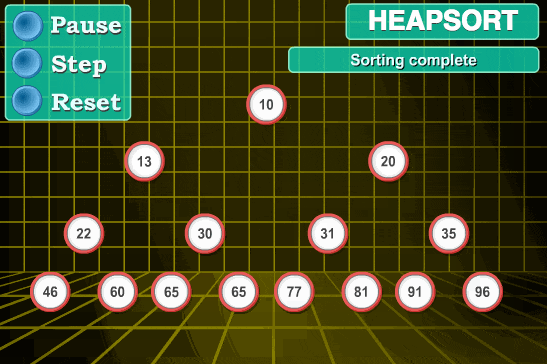
堆是近似完全二叉树,且满足子结点键值总小于(或大于)父节点。大顶堆用于升序,小顶堆用于降序。平均 O(n log n)。
-
-
-
堆尺寸减 1,shift_down(0) 把新顶端调整到位
-
var len;    // 因为声明的多个函数都需要数据长度,所以把len设置成为全局变量

function buildMaxHeap(arr) {   // 建立大顶堆
    len = arr.length;
    for (var i = Math.floor(len/2); i >= 0; i--) {
        heapify(arr, i);
    }
}

function heapify(arr, i) {     // 堆调整
    var left = 2 * i + 1,
        right = 2 * i + 2,
        largest = i;

    if (left < len && arr[left] > arr[largest]) {
        largest = left;
    }

    if (right < len && arr[right] > arr[largest]) {
        largest = right;
    }

    if (largest != i) {
        swap(arr, i, largest);
        heapify(arr, largest);
    }
}

function swap(arr, i, j) {
    var temp = arr[i];
    arr[i] = arr[j];
    arr[j] = temp;
}

function heapSort(arr) {
    buildMaxHeap(arr);

    for (var i = arr.length-1; i > 0; i--) {
        swap(arr, 0, i);
        len--;
        heapify(arr, 0);
    }
    return arr;
}
八、计数排序
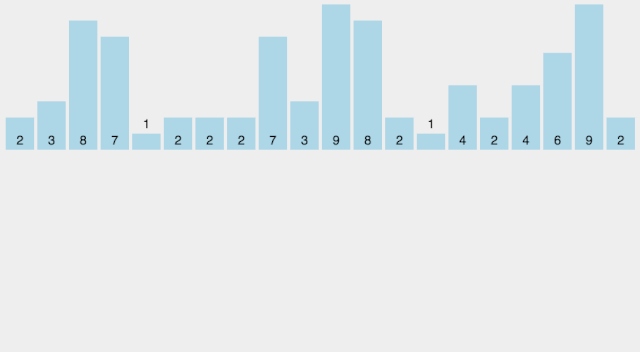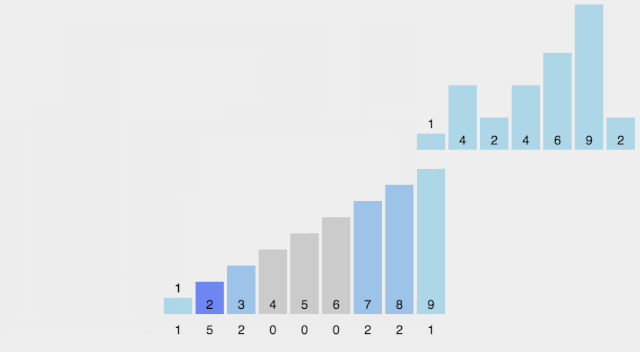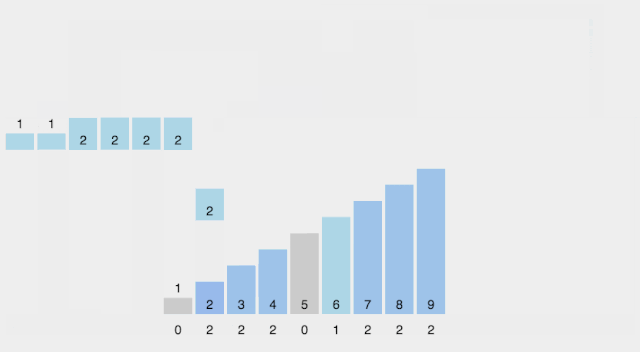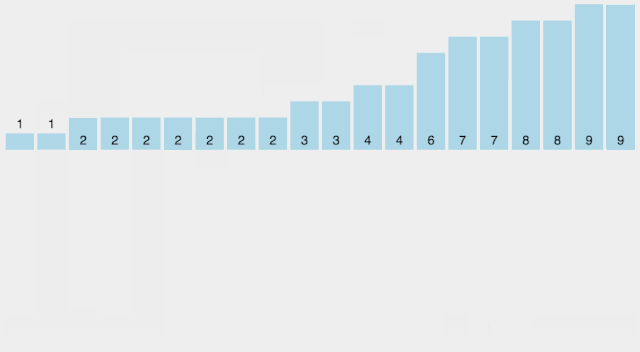
核心是把输入值变成键,存进额外数组。作为线性复杂度排序,它要求数据是有确定范围的整数。
动图演示:
function countingSort(arr, maxValue) {
    var bucket = new Array(maxValue+1),
        sortedIndex = 0;
        arrLen = arr.length,
        bucketLen = maxValue + 1;

    for (var i = 0; i < arrLen; i++) {
        if (!bucket[arr[i]]) {
            bucket[arr[i]] = 0;
        }
        bucket[arr[i]]++;
    }

    for (var j = 0; j < bucketLen; j++) {
        while(bucket[j] > 0) {
            arr[sortedIndex++] = j;
            bucket[j]--;
        }
    }

    return arr;
}
九、桶排序
桶排序是计数排序的升级,关键在映射函数。额外空间够时尽量增加桶数量,并让 N 个数据均匀分到 K 个桶;桶内再用比较排序,选用哪种算法会影响性能。
最快:数据能均匀分到每个桶。最慢:数据全进同一个桶。
function bucketSort(arr, bucketSize) {
    if (arr.length === 0) {
      return arr;
    }

    var i;
    var minValue = arr[0];
    var maxValue = arr[0];
    for (i = 1; i < arr.length; i++) {
      if (arr[i] < minValue) {
          minValue = arr[i];                // 输入数据的最小值
      } else if (arr[i] > maxValue) {
          maxValue = arr[i];                // 输入数据的最大值
      }
    }

    //桶的初始化
    var DEFAULT_BUCKET_SIZE = 5;            // 设置桶的默认数量为5
    bucketSize = bucketSize || DEFAULT_BUCKET_SIZE;
    var bucketCount = Math.floor((maxValue - minValue) / bucketSize) + 1;
    var buckets = new Array(bucketCount);
    for (i = 0; i < buckets.length; i++) {
        buckets[i] = [];
    }

    //利用映射函数将数据分配到各个桶中
    for (i = 0; i < arr.length; i++) {
        buckets[Math.floor((arr[i] - minValue) / bucketSize)].push(arr[i]);
    }

    arr.length = 0;
    for (i = 0; i < buckets.length; i++) {
        insertionSort(buckets[i]);                      // 对每个桶进行排序,这里使用了插入排序
        for (var j = 0; j < buckets[i].length; j++) {
            arr.push(buckets[i][j]);
        }
    }

    return arr;
}
十、基数排序
基数排序是非比较整数排序,按位切开再按每位分配。整数也能表达字符串、日期和特定浮点,所以不限于整数。
三种“桶”用法不同:
LSD 基数排序动图(原文配图文件名仍是计数排序 1):
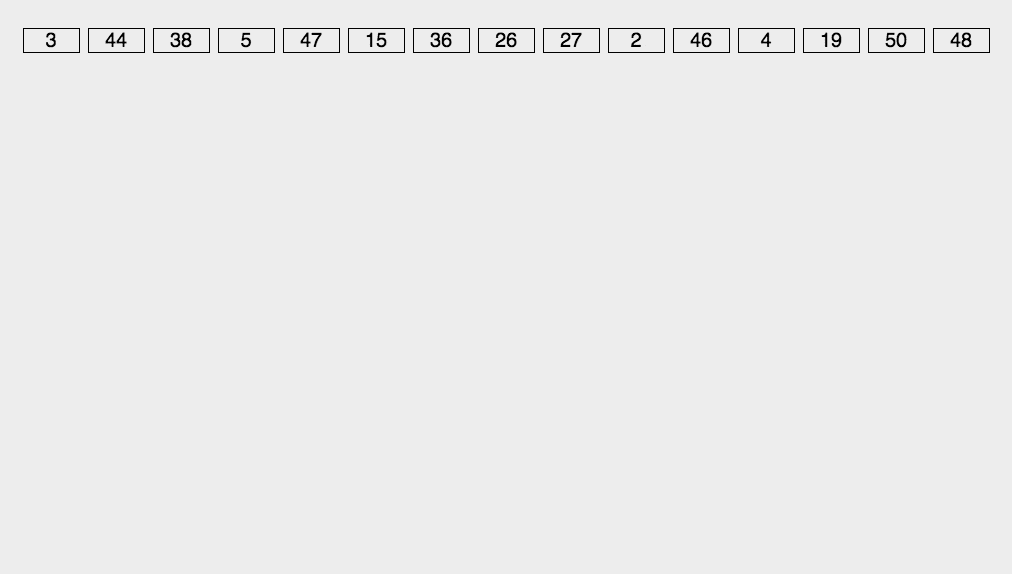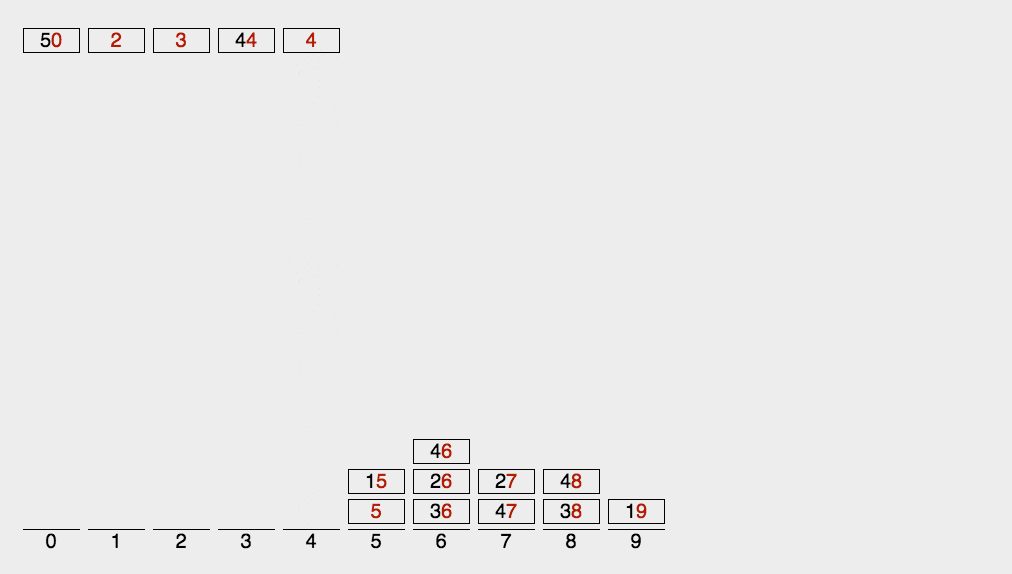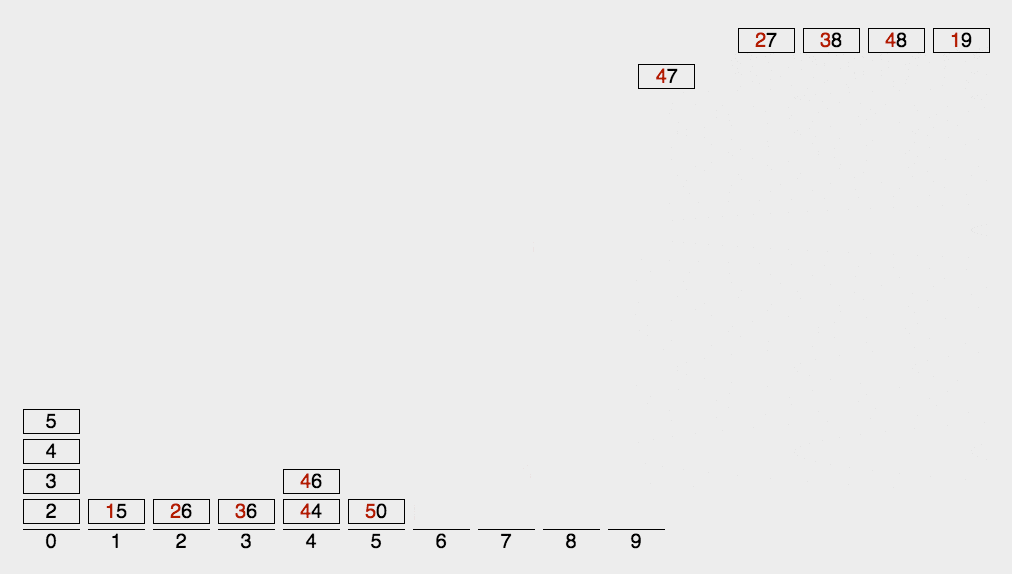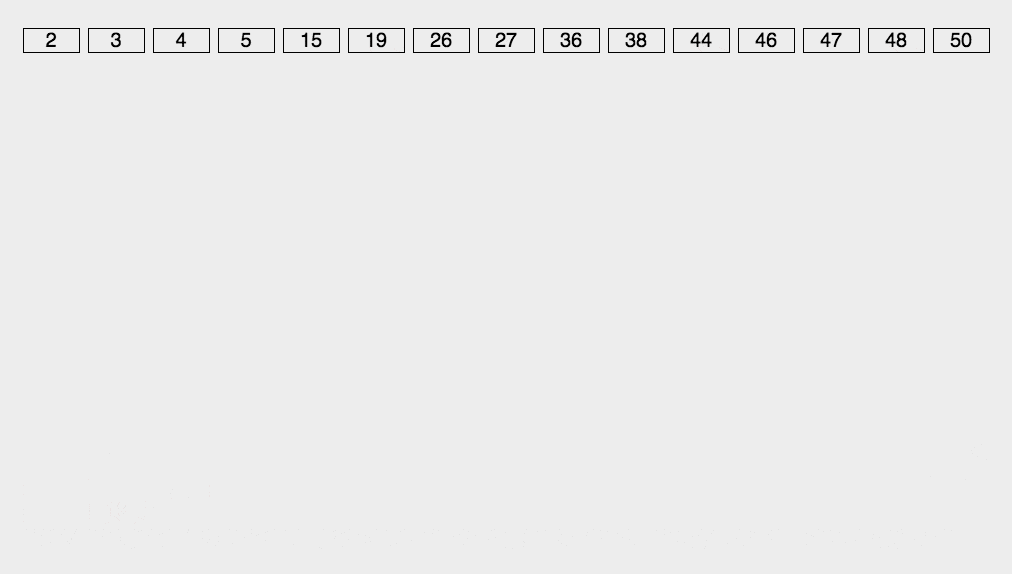
//LSD Radix Sort
var counter = [];
function radixSort(arr, maxDigit) {
    var mod = 10;
    var dev = 1;
    for (var i = 0; i < maxDigit; i++, dev *= 10, mod *= 10) {
        for(var j = 0; j < arr.length; j++) {
            var bucket = parseInt((arr[j] % mod) / dev);
            if(counter[bucket]==null) {
                counter[bucket] = [];
            }
            counter[bucket].push(arr[j]);
        }
        var pos = 0;
        for(var j = 0; j < counter.length; j++) {
            var value = null;
            if(counter[j]!=null) {
                while ((value = counter[j].shift()) != null) {
                      arr[pos++] = value;
                }
          }
        }
    }
    return arr;
}
| 算法 |
平均 |
最坏 |
稳定 |
额外空间 |
| 冒泡 / 选择 / 插入 |
O(n²) |
O(n²) |
冒泡插入稳定,选择否 |
O(1) |
| 希尔 |
约 O(n^1.3) |
O(n²) |
否 |
O(1) |
| 归并 / 堆 / 快速 |
O(n log n) |
快排最坏 O(n²) |
归并可稳定 |
归并 O(n) |
| 计数 / 桶 / 基数 |
接近线性 |
取决于分布 |
通常稳定 |
O(n + k) |
一句话总结:面试先能手写冒泡、插入、快排、归并;再说明堆、希尔和三种线性排序各自的数据约束与稳定性。